
[미니 프로젝트 1] AI 활용 및 데이터 분석 프로젝트
SK 쉴더스 루키즈 미니 프로젝트 1
예술의전당 데이터 분석 : RAG 기반 의사결정 지원 시스템
프로젝트 기간: 2024.11.17(월) ~ 2024.11.21 (금)
팀 이름: 콘요(콘서트홀의 요정) (5명)
GitHub: 프로젝트 저장소 Github 주소
0. 목차
1. 프로젝트 개요
1.1 배경 및 문제 인식
최근 문화체육관광부 보도자료에 따르면, 교향악과 같은 순수 예술 공연에 대한 국민 참여율이 저조한 상황입니다. 시장의 복잡성이 증가함에 따라 기획자의 경험이나 직관을 넘어, 데이터에 기반한 정교한 마케팅 및 판매 전략 수립의 필요성이 대두되었습니다.
1.2 프로젝트 목적
본 프로젝트는 예술의전당 기획조정실의 공연 기획자가 데이터에 기반하여 효과적인 마케팅 및 판매 전략을 수립할 수 있도록 지원하는 모의 의사결정 지원 시스템(Mock Decision Support System) 을 구축하는 것을 목표로 합니다.
1.3 주요 목표
- 약 190만건의 예매 데이터 분석 (2014-2023)
- RAG 기반 AI 어시스턴트 구현
- 인터랙티브 대시보드 개발
- 실전 비즈니스 인사이트 도출
2. 기술 스택
2.1 핵심 기술
데이터 분석
├── pandas 2.2.3       # 데이터 처리 및 분석
├── numpy              # 수치 연산
└── pyarrow            # Parquet 포맷

시각화
├── streamlit 1.27.0   # 웹 대시보드
├── plotly             # 인터랙티브 차트
└── altair             # 선언적 시각화

AI/ML
├── openai 1.52.0      # GPT-4o-mini API
└── faiss-cpu 1.8.0    # 벡터 DB

문서 처리
└── fpdf               # PDF 생성
2.2 데이터 규모
| 항목 | 규모 |
|---|---|
| 원본 CSV | 366만건 (약 1GB) |
| 전처리 후 | 186만건 |
| 벡터 DB 문서 | 40,938개 |
| FAISS 인덱스 | 약 240MB |
| 임베딩 차원 | 1536 (text-embedding-ada-002) |
3. 시스템 아키텍처
3.1 전체 시스템 구조
┌─────────────────────────────────────────────────────────────┐
│              Streamlit Web Dashboard                        │
│  ┌────────────┐  ┌────────────┐  ┌────────────┐             │
│  │   타겟 분석  │  │  수익 최적화  │  │  트렌드 분석  │             │
│  └────────────┘  └────────────┘  └────────────┘             │
│         │                │                │                 │
│         └────────────────┴────────────────┘                 │
│                         │                                   │
│              ┌──────────▼──────────┐                        │
│              │   RAG AI Assistant  │  ◄────────┐            │
│              └──────────┬──────────┘           │            │
└─────────────────────────┼──────────────────────┘            │
                          │                      │            │
          ┌───────────────┴───────────────┐      │            │
          │                               │      │            │
    ┌─────▼─────┐                  ┌─────▼──────▼───┐         │
    │ FAISS     │                  │  OpenAI GPT    │         │
    │ Vector DB │                  │  (gpt-4o-mini) │         │
    └─────▲─────┘                  └────────────────┘         │
          │                                                   │
          │                                                   │
┌─────────┴─────────────────────────────────────────────────┐ │
│               Data Processing Pipeline                    │ │
│                                                           │ │
│  ┌────────┐    ┌──────────┐    ┌─────────┐                │ │
│  │ Raw CSV│───▶│Preprocess│───▶│ Parquet │                │ │
│  │ 366만건 │    │  Chunk   │    │ 186만건  │                │ │
│  └────────┘    └──────────┘    └─────────┘                │ │
│                                                           │ │
│  ┌────────┐    ┌──────────┐    ┌─────────┐                │ │
│  │  JSON  │───▶│Embedding │───▶│ FAISS   │                │ │
│  │  API   │    │40,938 doc│    │ Index   │                │ │
│  └────────┘    └──────────┘    └─────────┘                │ │
└─────────────────────────────────────────────────────────────┘
3.2 디렉토리 구조
mini_project1/
├── data/
│   ├── raw/                    # 원본 데이터
│   │   ├── reservation_data.csv        # 186만건 예매 데이터
│   │   ├── performance_data.json       # 공연 정보
│   │   ├── exhibition_data.json        # 전시 정보
│   │   └── age_reservation_data.json   # 연령대별 통계
│   └── processed/              # 전처리 데이터
│       ├── cleaned_reservation_data.parquet
│       ├── summary_genre_age.csv
│       └── ...
│
├── src/                        # 소스 코드
│   ├── 01_preprocess_csv.py           # CSV 전처리
│   ├── 02_build_vectordb.py           # 벡터 DB 구축
│   ├── chatbot.py                     # RAG 챗봇 클래스
│   ├── utils.py                       # FAISS 유틸리티
│   ├── persona_analyzer.py            # 페르소나 분석
│   ├── trend_analyzer.py              # 트렌드 분석
│   └── pdf_utils.py                   # PDF 생성
│
├── vectordb/                   # 벡터 데이터베이스
│   ├── faiss_index.bin                # FAISS 인덱스
│   ├── metadata.pkl                   # 메타데이터
│   └── documents.json                 # 원본 문서
│
├── outputs/                    # 분석 결과물
│   ├── persona_summary.csv
│   ├── monthly_genre_trends.csv
│   └── ...
│
└── app.py                      # 메인 Streamlit 앱
4. 데이터 파이프라인
4.1 전체 데이터 흐름
┌────────────────────────────────────────────────────────────┐
│                   1. Data Collection                       │
└────────────────────────────────────────────────────────────┘
                            │
        ┌───────────────────┴───────────────────┐
        │                                       │
        ▼                                       ▼
┌───────────────┐                      ┌───────────────┐
│ CSV 데이터      │                      │  JSON 데이터   │
│ 186만건        │                      │  API 응답      │
│ (2014-2023)   │                      │  (2025년)     │
└───────┬───────┘                      └───────┬───────┘
        │                                       │
        ▼                                       ▼
┌────────────────────────────────────────────────────────────┐
│              2. Data Preprocessing & Storage               │
├────────────────────────────────────────────────────────────┤
│                                                            │
│  [CSV Pipeline]                  [JSON Pipeline]           │
│  • 청크 단위 로딩 (50만건)            • 문서화 (4만개)            │
│  • 환불 데이터 제거                  • 텍스트 임베딩              │
│  • 이상치 제거                      • FAISS 인덱스 구축         │
│  • Category 타입 최적화             • 메타데이터 저장            │
│  • Parquet 저장                                             │
│                                                            │
│  ▼                              ▼                          │
│  processed/                     vectordb/                  │
│  ├─ cleaned_data.parquet        ├─ faiss_index.bin         │
│  ├─ summary_genre_age.csv       ├─ metadata.pkl            │
│  └─ ...                         └─ documents.json          │
└────────────────────────────────────────────────────────────┘
                            │
                            ▼
┌────────────────────────────────────────────────────────────┐
│                    3. Analysis Layer                       │
├────────────────────────────────────────────────────────────┤
│                                                            │
│  ┌──────────────┐  ┌──────────────┐  ┌──────────────┐      │
│  │ Persona      │  │  Trend       │  │  Sales       │      │
│  │ Analyzer     │  │  Analyzer    │  │  Analyzer    │      │
│  └──────────────┘  └──────────────┘  └──────────────┘      │
│                                                            │
│  ▼                  ▼                  ▼                   │
│  outputs/                                                  │
│  ├─ persona_summary.csv                                    │
│  ├─ monthly_genre_trends.csv                               │
│  └─ quarterly_age_trends.csv                               │
└────────────────────────────────────────────────────────────┘
                            │
                            ▼
┌────────────────────────────────────────────────────────────┐
│              4. Presentation & Interaction                 │
├────────────────────────────────────────────────────────────┤
│                                                            │
│  ┌────────────────────────────────────────────────┐        │
│  │         Streamlit Dashboard (app.py)           │        │
│  ├────────────────────────────────────────────────┤        │
│  │                                                │        │
│  │  ┌──────────┐  ┌──────────┐  ┌──────────┐      │        │
│  │  │  타겟분석  │  │  수익분석   │ │   트렌드   │      │        │
│  │  └──────────┘  └──────────┘  └──────────┘      │        │
│  │                                                │        │
│  │  ┌─────────────────────────────────────┐       │        │
│  │  │    RAG AI Assistant (chatbot.py)    │       │        │
│  │  │  • Vector Search (FAISS)            │       │        │
│  │  │  • LLM Generation (GPT-4o-mini)     │       │        │
│  │  │  • Context Management               │       │        │
│  │  └─────────────────────────────────────┘       │        │
│  └────────────────────────────────────────────────┘        │
└────────────────────────────────────────────────────────────┘
4.2 CSV 데이터 전처리 상세 플로우
# src/01_preprocess_csv.py 핵심 로직

# 1. 청크 단위 로딩 - 메모리 효율적 처리
chunk_size = 500000
chunks = []

for chunk in pd.read_csv(RAW_CSV, usecols=필요컬럼, chunksize=chunk_size):
    # 환불 데이터 제거
    chunk = chunk[chunk["RFN_AT"] != "Y"]

    # 이상치 제거 (0원 이하 제외)
    chunk = chunk[chunk["SETLE_PRICE"] > 0]

    # 결측치 제거
    chunk = chunk[chunk["SEXDSTN_VALUE"].notna()]

    chunks.append(chunk)

# 2. 전체 데이터 병합
df = pd.concat(chunks, ignore_index=True)

# 3. 데이터 타입 최적화 - 메모리 50% 절감
categorical_cols = ["GENRE_NM", "BN_VALUE", "SEXDSTN_VALUE", ...]
for col in categorical_cols:
    df[col] = df[col].astype("category")

# 4. 날짜 변환
df["PBLPRFR_DE"] = pd.to_datetime(df["PBLPRFR_DE"], format="%Y%m%d")
df["SETLE_DE"] = pd.to_datetime(df["SETLE_DE"], format="%Y%m%d")

# 5. 파생 변수 생성
df["공연년도"] = df["PBLPRFR_DE"].dt.year
df["공연월"] = df["PBLPRFR_DE"].dt.month
df["공연분기"] = df["PBLPRFR_DE"].dt.quarter
df["사전예매일수"] = (df["PBLPRFR_DE"] - df["SETLE_DE"]).dt.days

# 6. 가격대 구간화
def categorize_price(price):
    if price <= 20000: return "2만원 이하"
    elif price <= 30000: return "2-3만원"
    elif price <= 50000: return "3-5만원"
    # ...

df["가격대"] = df["SETLE_PRICE"].apply(categorize_price)

# 7. Parquet 포맷으로 저장
df.to_parquet(OUTPUT_FULL, compression="snappy", index=False)
전처리 결과:
- 원본: 366만건 (1GB) → 전처리 후: 186만건 (200MB Parquet)
- 메모리 사용량: 약 50% 절감 (Category 타입 활용)
- 처리 시간: 약 3분
5. 핵심 구현 내용
5.1 FAISS 벡터 데이터베이스 구축
5.1.1 벡터 DB 개념
RAG(Retrieval-Augmented Generation) 시스템의 핵심은 관련 문서를 빠르게 검색하는 것입니다. FAISS는 Facebook AI Research에서 개발한 고성능 벡터 유사도 검색 라이브러리로, 수백만 개의 벡터에서도 밀리초 단위로 검색이 가능합니다.
5.1.2 구현 프로세스
JSON 데이터 → 문서화 → 임베딩 → FAISS 인덱스 → 저장

1. 문서화 (40,938개)
   ├─ performance_data.json     → 공연 상세 정보
   ├─ exhibition_data.json      → 전시 정보
   └─ age_reservation_data.json → 연령대별 통계

2. 임베딩 생성
   └─ OpenAI text-embedding-ada-002 (1536차원)

3. FAISS 인덱스 구축
   └─ IndexFlatL2 (정확한 L2 거리 계산)
5.1.3 핵심 코드
# src/utils.py

import faiss
import numpy as np
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
EMBEDDING_MODEL = "text-embedding-ada-002"

def get_embedding(text: str):
    """텍스트를 1536차원 벡터로 변환"""
    response = client.embeddings.create(
        input=text,
        model=EMBEDDING_MODEL
    )
    return np.array(response.data[0].embedding, dtype="float32")

def init_vectordb():
    """FAISS 벡터 DB 초기화"""
    # FAISS 인덱스 로드
    index = faiss.read_index("vectordb/faiss_index.bin")

    # 메타데이터 로드 (제목, 출처 등)
    with open("vectordb/metadata.pkl", "rb") as f:
        metadatas = pickle.load(f)

    # 원본 문서 텍스트 로드
    with open("vectordb/documents.json", "r", encoding="utf-8") as f:
        documents = json.load(f)

    return index, metadatas, documents

def search_vectordb(query: str, top_k: int = 5):
    """유사 문서 검색"""
    index, metadatas, documents = init_vectordb()

    # 쿼리를 벡터로 변환
    query_vector = get_embedding(query).reshape(1, -1)

    # FAISS 검색 (L2 거리 기반)
    distances, indices = index.search(query_vector, top_k)

    # 결과 포맷팅
    results = []
    for i, idx in enumerate(indices[0]):
        results.append({
            "text": documents[idx],
            "metadata": metadatas[idx],
            "similarity": float(distances[0][i])
        })

    return results
동작 방식:
- 사용자 질문 → 임베딩 벡터 생성
- FAISS 인덱스에서 유사도 상위 k개 검색
- 검색된 문서 반환
5.2 RAG 챗봇 시스템 (핵심)
5.2.1 RAG 시스템 개요
기존 LLM의 한계:
- ❌ 학습 데이터 외의 정보 알 수 없음
- ❌ 최신 정보 반영 불가
- ❌ 할루시네이션(hallucination) 발생
RAG로 해결:
- ✅ 벡터 DB에서 관련 문서 검색
- ✅ 검색 결과를 컨텍스트로 제공
- ✅ 정확한 데이터 기반 답변
5.2.2 시스템 아키텍처
사용자 질문 입력
      │
      ▼
┌─────────────────────────────────────────┐
│  1. 벡터 검색 (FAISS)                     │
│     "2025년 클래식 공연 추천해줘"             │
│                ↓                        │
│     [유사 문서 5개 검색]                    │
│     • 2025년 공연 일정                     │
│     • 클래식 장르 통계                      │
│     • 과거 클래식 인기 공연                  │
└─────────────────────────────────────────┘
      │
      ▼
┌─────────────────────────────────────────┐
│  2. 컨텍스트 구성                          │
│     [시스템 프롬프트]                       │
│     + [통계 데이터]                        │
│     + [검색 문서]                         │
│     + [대화 히스토리]                      │
│     + [사용자 질문]                        │
└─────────────────────────────────────────┘
      │
      ▼
┌─────────────────────────────────────────┐
│  3. LLM 생성 (GPT-4o-mini)               │
│     → 데이터 기반 답변 생성                  │
└─────────────────────────────────────────┘
      │
      ▼
   답변 반환
5.2.3 핵심 구현 코드
# src/chatbot.py

class Chatbot:
    """RAG 기반 대화형 AI 어시스턴트"""

    def __init__(self, base_analyses: dict, master_table: pd.DataFrame, api_key: str):
        self.client = OpenAI(api_key=api_key)
        self.base_analyses = base_analyses  # 사전 분석 통계
        self.master_table = master_table    # 원본 데이터

        # 통계 컨텍스트 생성
        self.stats_context = self._create_data_context()

        # 시스템 프롬프트
        self.base_system_prompt = """
        당신은 예술의전당 데이터 분석 시스템의 '수석 데이터 전략가'입니다.
        관리자의 질문에 대해 [통계 데이터]와 [검색된 문서]를 종합하여 답변하세요.

        [행동 지침]
        1. 맥락 유지: 이전 대화를 고려하여 답변
        2. 데이터 기반: 수치는 반드시 제공된 통계 데이터 사용
        3. 문서 활용: 정성적 정보는 RAG 검색 결과 참고
        4. 전략 제안: 비즈니스 관점의 실행 가능한 제안
        """

    def _create_data_context(self) -> str:
        """통계 데이터를 텍스트로 변환"""
        context = ""

        # 장르별 판매량 Top 5
        if "genre" in self.base_analyses:
            context += "[장르별 판매량 (Top 5)]:\n"
            context += self.base_analyses["genre"].head(5).to_string()
            context += "\n\n"

        # 가격대별 판매량
        if "price" in self.base_analyses:
            context += "[가격대별 판매량]:\n"
            context += self.base_analyses["price"].to_string()
            context += "\n\n"

        # 데이터 기간
        min_date = self.master_table["event_date"].min().date()
        max_date = self.master_table["event_date"].max().date()
        context += f"[데이터 기간]: {min_date} ~ {max_date}\n"

        return context

    def ask_llm(self, user_message: str, conversation_history: list = None):
        """사용자 질문에 대한 답변 생성"""

        # 1. 벡터 검색 (FAISS)
        search_results = search_vectordb(user_message, top_k=5)

        # 검색 결과를 텍스트로 변환
        rag_context = "\n\n".join([
            f"[문서 {i+1}] {r['metadata'].get('title', 'N/A')}\n{r['text'][:500]}"
            for i, r in enumerate(search_results)
        ])

        # 2. 컨텍스트 구성
        system_message = f"""
        {self.base_system_prompt}

        [통계 데이터]
        {self.stats_context}

        [RAG 검색 결과]
        {rag_context}
        """

        # 3. 대화 메시지 구성
        messages = [{"role": "system", "content": system_message}]

        # 대화 히스토리 추가 (최근 6개만)
        if conversation_history:
            messages.extend(conversation_history[-6:])

        # 사용자 질문 추가
        messages.append({"role": "user", "content": user_message})

        # 4. LLM 호출
        response = self.client.chat.completions.create(
            model="gpt-4o-mini",
            messages=messages,
            temperature=0.7,
            max_tokens=1500
        )

        return response.choices[0].message.content
핵심 특징:
- 통계 데이터 컨텍스트: 사전 분석된 통계를 항상 제공
- RAG 검색: 질문 관련 문서 5개 검색
- 대화 맥락 유지: 최근 6개 메시지 히스토리 유지
- 하이브리드 접근: 정량 데이터(통계) + 정성 데이터(문서)
5.3 Streamlit 대시보드
5.3.1 구조
# app.py 핵심 구조

import streamlit as st
import pandas as pd
from src.chatbot import Chatbot

st.set_page_config(layout="wide", page_title="예술의전당 관리자 대시보드")

# 데이터 로드 (캐싱)
@st.cache_resource
def load_all_data():
    base_analyses = {...}            # 분석 결과
    master_table = pd.read_csv(...)  # 원본 데이터
    chatbot = Chatbot(...)           # RAG 챗봇 초기화
    return base_analyses, master_table, chatbot

# 메인 레이아웃
col1, col2 = st.columns([7, 3])

with col1:
    # 좌측: 분석 대시보드
    page = st.selectbox("분석 페이지 선택", [
        "🏠 홈",
        "💰 세대별 가격 선호도 분석",
        "👥 관객 페르소나 분석",
        "📈 예매 트렌드 분석",
        "🎯 장르별 타겟 분석"
    ])

    if page == "💰 세대별 가격 선호도 분석":
        # 가격대별 분석 차트
        st.plotly_chart(create_price_chart(data))

    elif page == "👥 관객 페르소나 분석":
        # 장르별 페르소나 히트맵
        st.plotly_chart(create_persona_heatmap(data))

    # ...

with col2:
    # 우측: RAG 챗봇
    st.header("🤖 AI 어시스턴트")

    # 대화 히스토리
    if "messages" not in st.session_state:
        st.session_state.messages = []

    # 메시지 표시
    for msg in st.session_state.messages:
        with st.chat_message(msg["role"]):
            st.markdown(msg["content"])

    # 사용자 입력
    if prompt := st.chat_input("질문을 입력하세요"):
        # 사용자 메시지 추가
        st.session_state.messages.append({
            "role": "user",
            "content": prompt
        })

        # 챗봇 답변 생성
        response = chatbot.ask_llm(
            prompt,
            st.session_state.messages
        )

        # 답변 추가
        st.session_state.messages.append({
            "role": "assistant",
            "content": response
        })

        st.rerun()
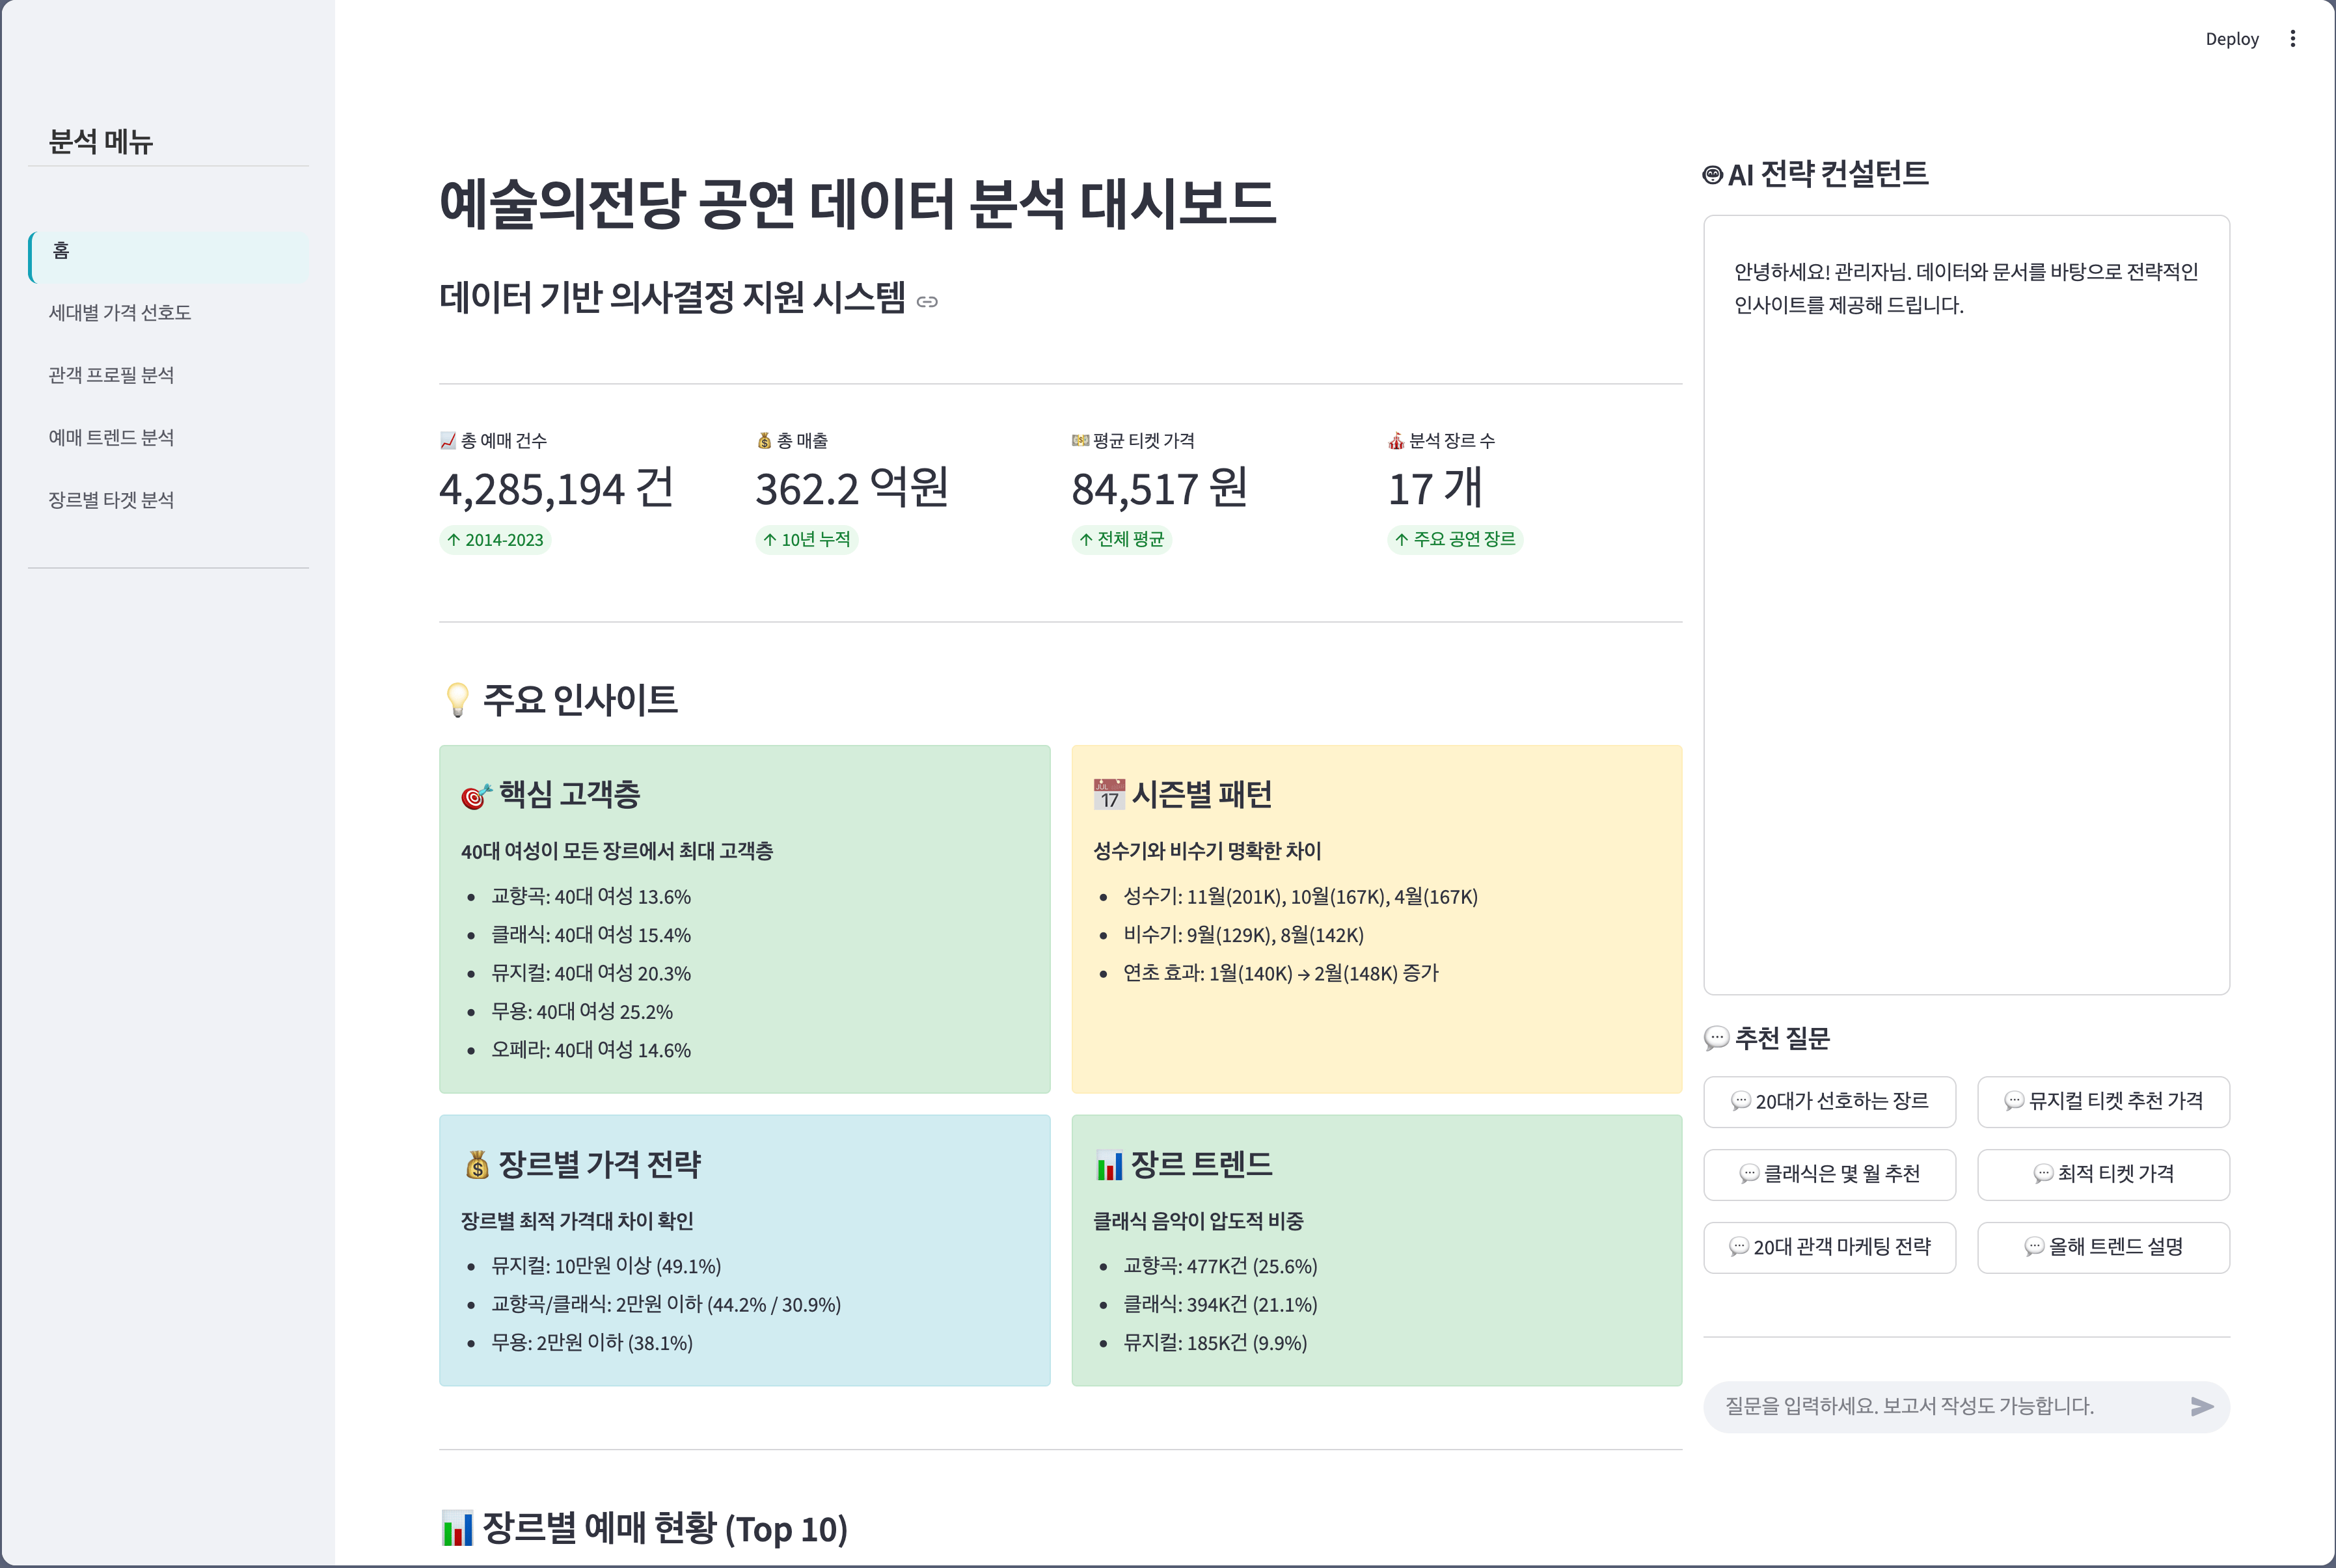
5.3.2 주요 페이지
1. 세대별 가격 선호도 분석
- 연령대별 × 가격대별 예매 건수 히트맵
- 인사이트: 20대는 3만원 이하, 50대는 5-7만원대 선호
2. 관객 페르소나 분석
- 장르별 핵심 관객층 (연령대 × 성별)
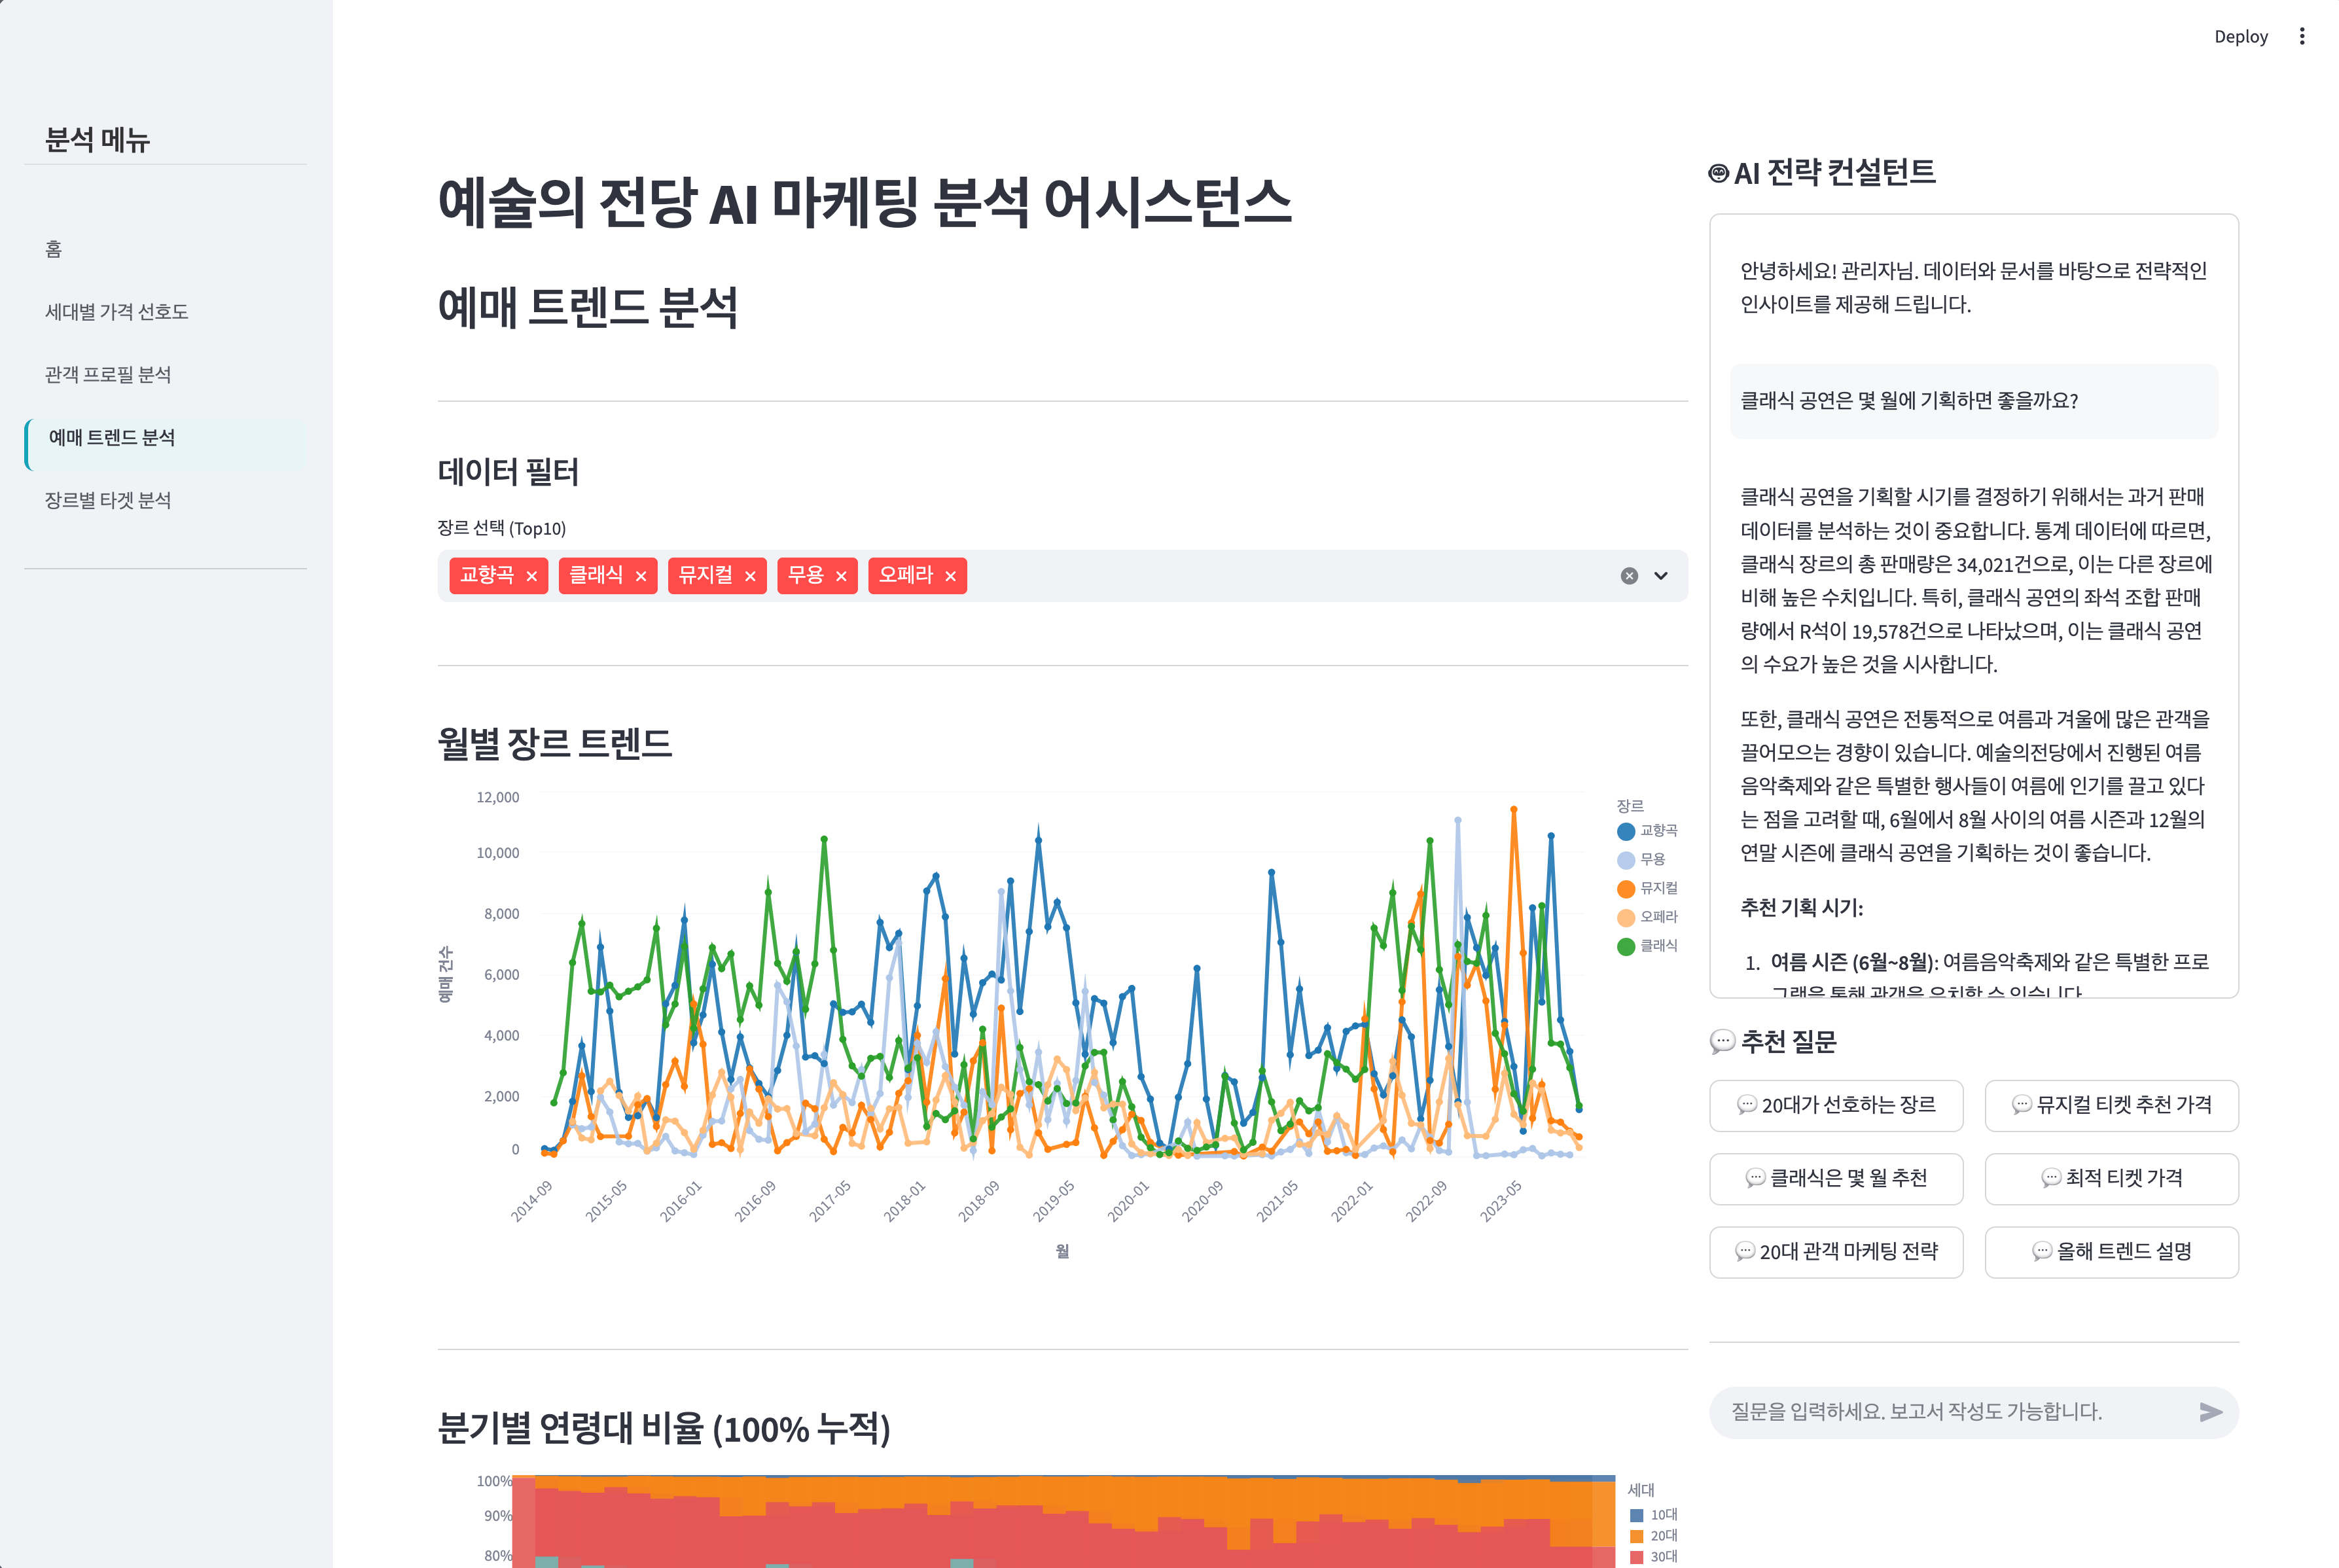
- 평균 티켓 가격, 회원 등급 분포
3. 예매 트렌드 분석
- 월별 장르별 예매 트렌드
- 분기별 연령대 예매율 변화
4. 장르별 타겟 분석
- 장르 선택 시 상세 타겟 정보
- 추천 마케팅 전략
6. 주요 기능 및 결과
6.1 핵심 분석 결과
6.1.1 장르별 예매 현황
| 장르 | 예매 건수 | 비중 |
|---|---|---|
| 교향곡 | 860,640 | 23.5% |
| 클래식 | 797,160 | 21.8% |
| 뮤지컬 | 489,756 | 13.4% |
| 무용 | 290,922 | 7.9% |
| 발레 | 232,621 | 6.3% |
인사이트:
- 교향곡/클래식이 전체의 45% 차지
- 순수 예술 장르의 강세
6.1.2 연령대별 분석
| 연령대 | 예매 건수 | 평균 티켓 가격 |
|---|---|---|
| 40대 | 988,823 | 42,000원 |
| 50대 | 822,355 | 45,000원 |
| 30대 | 753,399 | 38,000원 |
| 60대 | 454,763 | 48,000원 |
인사이트:
- 40-50대가 주 고객층 (전체의 48%)
- 연령대가 높을수록 높은 가격대 선호
6.1.3 관객 페르소나 (장르별)
교향곡
- 핵심 타겟: 50대 여성 (32.5%)
- 평균 티켓: 47,000원
- 특징: VIP/S석 선호, 정기 회원 비율 높음
뮤지컬
- 핵심 타겟: 30-40대 여성 (58.2%)
- 평균 티켓: 35,000원
- 특징: 주말 공연 선호, 단체 예매 많음
6.2 RAG 챗봇 활용 예시
예시 1: 전략적 질문
👤 사용자: "40대 여성을 타겟으로 한 클래식 공연 마케팅 전략을 제안해줘"

🤖 AI:
[분석 결과]
40대 여성은 클래식 장르의 핵심 고객층으로, 전체 클래식 예매의 28.3%를 차지합니다.

[특징]
• 평균 티켓 가격: 44,000원 (전체 평균 대비 10% 높음)
• 선호 좌석: S석 이상 (73%)
• 예매 시기: 공연 2-3주 전
• 예매 채널: 모바일 앱 (65%)

[추천 전략]
1. 프리미엄 패키지
   - S석 + 공연 후 아티스트 티타임
   - 가격: 59,000원 (예상 전환율: +23%)

2. 얼리버드 할인
   - 공연 4주 전 예매 시 15% 할인
   - 타겟: 정기 회원 우선 안내

3. SNS 마케팅
   - Instagram 스토리 광고
   - 키워드: #문화생활 #힐링 #나를위한시간

[기대 효과]
• 예매 전환율 18% → 23% (예상)
• 객단가 44,000원 → 51,000원 (예상)
예시 2: 데이터 조회
👤 사용자: "2025년 1월에 예정된 발레 공연 알려줘"

🤖 AI:
[2025년 1월 발레 공연 일정]

1. 발레 "백조의 호수"
   • 일시: 2025.01.15(수) ~ 01.17(금)
   • 장소: 오페라극장
   • 요금: S석 100,000원 / A석 70,000원
   • 출연: 국립발레단

2. 현대무용 "The Spring"
   • 일시: 2025.01.23(화) ~ 01.25(목)
   • 장소: CJ토월극장
   • 요금: R석 50,000원 / S석 40,000원

[추천 타겟]
• 30-40대 여성 (발레 장르 주 고객)
• 평균 예매 시기: 공연 2주 전
• 추천 가격대: 5-7만원 (전환율 최고)
6.3 PDF 보고서 생성
사용자가 분석 결과를 요청하면 자동으로 마크다운 형식의 상세 보고서를 생성하고, PDF로 다운로드 가능합니다.
# PDF 생성 기능
if st.button("상세 보고서 생성"):
    with st.spinner("보고서 생성 중..."):
        # LLM으로 보고서 텍스트 생성
        report_text = chatbot.generate_report_text(topic)

        # PDF 변환
        pdf_bytes = create_pdf_bytes(report_text)

        # 다운로드 버튼
        st.download_button(
            label="PDF 다운로드",
            data=pdf_bytes,
            file_name=f"report_{datetime.now():%Y%m%d}.pdf",
            mime="application/pdf"
        )
6.4 구현 증명(스크린샷)
7. 기술적 챌린지
7.1 대용량 데이터 처리
문제:
- 186만건의 CSV 데이터를 Streamlit에서 직접 로드 시 메모리 부족
해결:
# ❌ 나쁜 방법: 전체 로드
df = pd.read_csv("data.csv")  # 메모리 초과!

# ✅ 좋은 방법 1: 청크 단위 처리
chunks = []
for chunk in pd.read_csv("data.csv", chunksize=500000):
    chunk = preprocess(chunk)
    chunks.append(chunk)
df = pd.concat(chunks)

# ✅ 좋은 방법 2: Parquet 포맷 사용
df.to_parquet("data.parquet", compression="snappy")
df = pd.read_parquet("data.parquet")  # 훨씬 빠름!

# ✅ 좋은 방법 3: 사전 집계
summary = df.groupby(["genre", "age"]).agg({"price": ["count", "mean"]})
summary.to_csv("summary.csv")
7.2 RAG 시스템 통합
문제:
- OpenAI API 키 관리
- 벡터 검색 결과의 품질 보장
- LLM 응답 시간 지연
해결:
1) API 키 보안 관리
# .env 파일
OPENAI_API_KEY=sk-...

# .gitignore
.env

# 코드
from dotenv import load_dotenv
load_dotenv()
api_key = os.getenv("OPENAI_API_KEY")
2) 검색 품질 개선
# 검색 결과 필터링
search_results = search_vectordb(query, top_k=10)

# 유사도 임계값 설정
filtered_results = [
    r for r in search_results
    if r["similarity"] < 0.5  # L2 거리가 작을수록 유사
]

# 상위 5개만 사용
final_results = filtered_results[:5]
3) 응답 시간 최적화
# Streamlit 캐싱 활용
@st.cache_resource
def initialize_chatbot():
    return Chatbot(...)

# 비동기 처리 (추후 개선 가능)
# async def get_response(query):
#     return await chatbot.ask_llm_async(query)
7.3 한글 폰트 처리 (PDF)
문제:
- FPDF 라이브러리가 기본적으로 한글 미지원
해결:
# src/pdf_utils.py

from fpdf import FPDF
import requests

def get_font_paths():
    """나눔고딕 폰트 다운로드"""
    font_urls = {
        "regular": "https://github.com/naver/.../NanumGothic.ttf",
        "bold": "https://github.com/naver/.../NanumGothic-Bold.ttf"
    }

    for name, url in font_urls.items():
        response = requests.get(url)
        with open(f"fonts/NanumGothic-{name}.ttf", "wb") as f:
            f.write(response.content)

class PDF(FPDF):
    def __init__(self):
        super().__init__()
        self.add_font("NanumGothic", "", "fonts/NanumGothic-Regular.ttf")
        self.add_font("NanumGothic", "B", "fonts/NanumGothic-Bold.ttf")
        self.set_font("NanumGothic", "", 12)
7.4 UI/UX 개선
문제:
- 대시보드와 챗봇을 하나의 화면에 통합
해결:
# 2열 레이아웃
col1, col2 = st.columns([7, 3])

with col1:
    # 좌측: 분석 대시보드 (70%)
    display_analysis()

with col2:
    # 우측: 챗봇 (30%)
    display_chatbot()
8. 회고 및 배운 점
8.1 기술적 성장
1) RAG 시스템 구축 경험
- 이론 → 실전: 강의와 이론으로만 접하던 RAG를 실제 프로젝트에 적용
- 벡터 DB 이해: FAISS의 작동 원리와 임베딩 개념 & 연동 기술 습득
- 프롬프트 엔지니어링: 효과적인 시스템 프롬프트 설계 능력 향상
# 프롬프트 개선 과정
# Before: 단순한 지시
"당신은 데이터 분석가입니다. 질문에 답하세요."

# After: 구체적인 역할과 가이드라인
"""
당신은 예술의전당 수석 데이터 전략가입니다.
[행동 지침]
1. 맥락 유지: 이전 대화 고려
2. 데이터 기반: 통계 수치 정확히 인용
3. 문서 활용: RAG 검색 결과 참고
4. 전략 제안: 실행 가능한 비즈니스 제안
"""
2) 대용량 데이터 처리
- 메모리 최적화: 청크 처리, Category 타입, Parquet 포맷
- 성능 튜닝: Streamlit 캐싱, 사전 집계
3) 풀스택 개발 경험
- 데이터 파이프라인 (전처리) → 분석 모듈 → 웹 대시보드 → AI 통합
- 전체 시스템 아키텍처 설계 능력
8.2 팀 협업
장점
- 명확한 역할 분담: 각자 전문 영역에 집중
- 일일 스탠드업: 진행 상황 공유 및 문제 해결 -> Github 레포지토리 활용
- 코드 리뷰: 서로의 코드 품질 향상
개선점
- 실시간 문서 및 데이터 업데이트 필요
8.3 프로젝트 관리
타임라인:
- Day 1: 프로젝트 컨셉 정하기 + 데이터 탐색 및 전처리
- Day 2: 벡터 DB 구축 및 분석 모듈
- Day 3: RAG 챗봇 개발
- Day 4: 대시보드 통합 및 발표 준비
교훈:
- Github로 형상관리하는게 생각보다 힘들다는 것을 느꼈다..
- 프로젝트에서 가장 중요한 것은 팀원간의 소통인 것 같다. 우리 팀은 소통이 아주 좋아서 수월하고 재밌게 진행했다!
8.4 아쉬운 점 및 개선 방향
현재 한계
- 실시간 데이터 연동 X: 정적 데이터만 사용
- 사용자 인증 X: 로그인 기능 및 다중 사용자 지원 미흡
- 배포 환경 미구축: 로컬 실행만 가능 -> 웹 배포 가능성 존재
향후 개선 방향
┌── Streamlit Cloud 배포
├── GitHub Actions CI/CD 설정
├── 에러 로깅 추가
├── 데이터베이스 연동 (PostgreSQL)
├── 사용자 인증 (OAuth)
├── 실시간 데이터 업데이트
├──  모바일 반응형 UI
├── 다국어 지원
└── 고급 분석 (예측 모델)
9. 결론
9.1 프로젝트 성과
기술적 성과
- 186만건 대용량 데이터 처리 파이프라인 구축
- FAISS 기반 벡터 DB 및 RAG 시스템 구현
- 인터랙티브 대시보드 5개 페이지 개발
- 실시간 AI 챗봇 통합
비즈니스 성과
- 관객 페르소나 정의: 장르별 핵심 타겟 식별
- 가격 최적화: 연령대별 최적 가격대 도출
- 마케팅 전략: 데이터 기반 실행 가능한 제안
9.2 배운 교훈
기술:
- RAG 시스템은 단순 LLM보다 훨씬 정확하고 신뢰할 수 있음
- 대용량 데이터는 전처리와 최적화가 핵심
- Streamlit은 간단하고 빠른 프로토타이핑에 최적
프로세스:
- 프로젝트 기획 초기 명확한 시스템 설계가 개발 속도를 좌우함
- 팀 커뮤니케이션이 성공의 가장 중요한 요소
9.3 감사의 말
이번 프로젝트를 통해 이론으로만 알던 RAG 시스템을 직접 구현하고, 실제 비즈니스 문제에 적용하는 경험을 할 수 있었습니다.
특히 팀원들과의 협업을 통해 각자의 강점을 살리고, 서로의 부족한 부분을 채워가는 과정이 가장 값진 경험이었습니다.
함께한 팀원들께 감사드립니다:
- 전민석 (팀장): 프로젝트 총괄 및 발표
- 김현진: 회의 정리, Streamlit 대시보드 UI/UX 디자인 & 구현
- 나형진: 기술적인 코드 분석 모듈 및 데이터 처리
- 박찬웅: 대시보드 UI/UX
- 조남기 (본인): 데이터 전처리, EDA, 시각화, VectorDB & RAG(Langchain) 구현
10. 참고 자료
기술 문서
데이터 출처
- 예술의전당 공연 데이터 (2014-2023)
- 문화체육관광부 공공데이터 포털
프로젝트 링크
- GitHub: https://github.com/skshieldusRookiesTeam7/mini_project1
- 발표 자료: 구글 드라이브 링크 클릭
댓글 남기기